Landung in Cebu um 11:10, vier Stunden Straße bis zum Hafen, dann das Boot nach Malapascua. Im Dunkeln fährt kein Boot mehr rüber, das verbietet die Küstenwache. Die Sonne ging um 17:17 unter, die letzte Überfahrt um 17:30. Im Plan blieben zwischen Ankunft und Dunkelheit 20 bis 40 Minuten.
Solche Ketten habe ich früher selbst recherchiert, und das hat ewig gedauert. Wohin und wann war meist schnell klar. Die Zeit ging für die Feinheiten drauf: Klappt die Überfahrt noch am selben Tag? Welcher Flug passt wirklich? Und wie verhindere ich, dass ich einen Urlaubstag opfere und die gewonnene Zeit dann in einem schlechten Transferfenster wieder verliere? Ändert sich eine Kleinigkeit, eine Abfahrtszeit oder ein Flugplan, plant man die ganze Kette neu. Irgendwann macht man es dann nach 80/20.
Heute rechnet das ein Team aus KI-Agenten für mich durch, also aus KIs, die eine Aufgabe selbstständig abarbeiten: suchen, lesen, rechnen, aufschreiben. Ein Orchestrator, eine Art Dirigent, spricht mit mir und verteilt die Arbeit. Sieben Rechercheure suchen, ein Evaluator sagt vorher, was mir gefallen wird, und ein Prüfgremium liest jeden Plan aus mehreren Blickwinkeln gegen. Jede Aussage kommt mit Quelle, und ändert sich ein Glied der Kette, rechnet das System neu, bei der Anreise oben bis zum Sonnenuntergang. Gebaut habe ich das nebenbei, während ich meine Tauchreise auf die Philippinen geplant habe, mit Claude Code in meinem gewohnten Setup. Gedacht ist es für alle meine Reisen. Buchen tue ich weiterhin selbst.
Neue Begriffe erklären die Klappboxen Einfach erklärt, Tiefer abtauchen ist für alle, die es genau wissen wollen. Wer nur wissen will, was das System bringt, liest bis Umplanen vom Handy. Ab Unter der Haube wird es technisch, ganz unten steht, wie man so etwas selbst baut.
Der knappste Tag der Reise
Malapascua, das Ziel der Anreise vom Anfang, ist eine kleine Insel im Norden von Cebu, bekannt für ihre Fuchshaie, und hat keinen Flughafen. Vom Flughafen in Cebu sind es rund 150 Kilometer Straße bis zum Hafen Maya, dann geht es mit dem Boot weiter. Klingt nach einem halben Tag. Durchgerechnet sah es so aus:
Die Kette hat drei harte Grenzen, und alle hängen an der Küstenwache: Im Dunkeln fährt kein Boot mehr rüber. Die letzte Überfahrt geht laut Küstenwache um 17:30, die Sonne geht um 17:17 unter. Und die Tauchbasis holt deshalb nur ab, wer vor 12 Uhr in Cebu landet, alle anderen übernachten in Cebu City. Nach Plan legt das Boot gegen 17 Uhr an, eine Viertelstunde vor Sonnenuntergang. Im Plan stand an dieser Stelle „knappste Stelle der Reise“.
Dazu kamen Kleinigkeiten, die man beim Selbstrecherchieren leicht übersieht:
- Mein Plan rechnete zuerst mit 12:45 Uhr als letzter Abfahrt vom Flughafen, eine andere Tauchbasis nannte 13:30 Uhr als späteste Landung. Den Widerspruch hat das Prüfgremium gefunden. Die Basis, bei der ich dann gebucht habe, sagt: Landung vor 12 Uhr. Jetzt gilt diese, die strengste Frist.
- Für die letzte Überfahrt nennt die Küstenwache 17:30, andere Quellen 16:00 oder 16:30. Das System lässt den Widerspruch stehen und plant mit einem vorbestellten Boot, das in Maya wartet.
- Eine ältere Übersichtsseite führte eine Fähre noch als „stündlich“. Laut Meldung des Betreibers fuhr sie seit Juli tagsüber nur noch alle drei Stunden, ein zweiter Betreiber weiter alle 90 Minuten.
- Ein Inlandsflug stand bei einer Quelle mit 14:55, bei einer anderen mit 15:50: Sommer- gegen Winterflugplan. Die Umsteigezeit wäre damit von 85 auf 30 Minuten geschrumpft.
Verschiebt sich eines dieser Glieder, rechnet das System die Kette bis zum Boot und zum Sonnenuntergang neu. Für den Fall, dass trotzdem etwas reißt, steht der Plan B fest: Verspätung, Landung nach 12 Uhr oder Sturmwarnung heißt eine Nacht in Cebu City und das erste Boot am Morgen. Das kostet einen halben Inseltag, die Haitage liegen später in der Woche und bleiben.
Gebraucht habe ich ihn nicht. In meinem Reisebericht für Familie und Freunde steht: „Am Hafen wartet schon das Tauchboot auf mich.“ Und kurz darauf: „Währenddessen geht die Sonne unter, und dafür hat sich die 24-Stunden-Anreise schon gelohnt.“ Ganz lag Claude aber nicht richtig. Den ersten Tag auf der Insel hatte es fürs Ankommen eingeplant. Ich bin direkt ins Wasser, und das war richtig so.
Einfach erklärt
Ein Chatbot beantwortet eine Frage. Ein KI-Agent bekommt eine Aufgabe und arbeitet sie selbst ab: Er sucht im Web, liest Seiten, rechnet, legt seine Ergebnisse in Dateien ab und macht weiter, bis die Aufgabe erledigt ist. Für diesen Anreisetag hat ein Agent, mein Logistik-Spezialist, Fahrzeiten, Fristen und Abfahrten zusammengetragen und jede Strecke als „bestanden“, „knapp“ oder „nicht bestanden“ bewertet. Gelesen und entschieden habe ich.
Tiefer abtauchen
Der Logistik-Spezialist liefert für jede Strecke dieselben Felder: von wo nach wo, womit, die realistische Dauer statt des Idealwerts, den Puffer, die Abfahrtszeiten mit Abrufdatum, das Ausfallrisiko und einen Plan B. Danach prüft er die Kette gegen feste Bedingungen: Ankunft gegen letzte Fähre und Tageslicht, den Anschluss zum Rückflug, die Flugpause nach dem letzten Tauchgang und ob die Kameraausrüstung in den Transfer passt. Er bucht nie, und ob mir eine Strecke gefällt, bewertet er auch nicht. Das ist Sache des Evaluators.
Mehr Urlaub aus jedem Urlaubstag
Die zweite Frage, an der ich früher lange saß: Wie hole ich aus Budget und Urlaubstagen das Maximum? Dafür hat das System ein paar feste Regeln von mir.
Ein Morgenflug am Freitag würde den Freitag zum Urlaubstag machen: +1.
Ein Abflug am Freitag ab 16 Uhr kostet keinen Urlaubstag, eine Landung am Montag vor 10 Uhr auch nicht. Ein Morgenflug kostet einen. Ein Abflug am Freitagabend kostet deshalb genauso viele Urlaubstage wie einer am Samstagmorgen, bringt aber einen Tag mehr vor Ort. Diesen Fall prüft das System jedes Mal ausdrücklich.
Die günstigste Verbindung ist nicht automatisch die beste. Eine der Optionen hätte 33 Stunden Anreise bedeutet. Das war mir zu lang, also hat das System den Preisunterschied gerechnet: gleiche Landezeit, 16 Stunden unterwegs, 96 Euro mehr. Für jede zusätzliche Nacht vor Ort gilt meine Faustregel: bis 150 Euro lohnt es sich klar, zwischen 150 und 300 Euro entscheidet das Bauchgefühl, darüber wird es schwierig.
Verfehlt eine Verbindung meine Zeitgrenzen um weniger als eine Stunde, zeigt das System sie trotzdem, mit beiden Rechnungen. Das war mein eigener Wunsch: Knappe Fälle will ich sehen und selbst abwägen.
Einfach erklärt
Sprachmodelle sind stark mit Sprache und erstaunlich unzuverlässig beim Zählen. Fragt man eine KI, wie viele Arbeitstage zwischen zwei Daten liegen, klingt die Antwort überzeugend und ist trotzdem manchmal falsch. Deshalb rechnet bei mir ein kleines, festes Programm die Urlaubstage aus, mit den Feiertagen meines Bundeslands. Die KI ruft es nur auf und erklärt mir das Ergebnis.
Tiefer abtauchen
Das Skript kommt ohne Internet und ohne Zusatzpakete aus, nur mit der Python-Standardbibliothek. Es geht jedes mögliche Paar aus Abflug- und Rückflugtag im Zeitraum durch. Abflug- und Landetag kosten keinen Urlaubstag, jeder Arbeitstag dazwischen einen, Wochenenden und Feiertage nichts. Ein Abflug an einem Arbeitstag vor 16 Uhr oder eine Landung an einem Arbeitstag ab 10 Uhr kostet einen Tag Aufschlag.
Dann fliegt alles raus, was geschlagen wird: Ein Fenster verschwindet, wenn ein anderes höchstens gleich viele Urlaubstage kostet, mindestens gleich viele Tage weg bringt und in einem Punkt echt besser ist, ein sogenannter Pareto-Filter. Übrig bleiben pro Urlaubstag-Stufe die besten Fenster, dazu Fenster mit Wochenende an beiden Enden. Fünf bis acht davon gehen an den Flug-Spezialisten, der pro Fenster Preise holt. Bei mir kommen drei bis fünf Fenster an, mit Tagen weg, Urlaubstagen, Preis, Flugzeiten und Umstiegen. Liegt eine Zeit weniger als 60 Minuten über der Grenze, steht sie als „knapp“ mit beiden Lesarten da.
Taifun: zwei von fünfzehn Jahren
Ich hatte gehört, dass Taifune den Fährverkehr lahmlegen und einem den Urlaub vermiesen können. Im Urlaub will ich das Risiko klein halten, und Taifune sind auf den Philippinen im November nun mal ein Thema. Also hat der Spezialist für die amtliche Lage nachgezählt.
In den letzten 15 Jahren gab es im selben Reisezeitraum zwei Direkttreffer auf Cebu und Negros: 2013 Haiyan, der Malapascua schwer getroffen hat, und 2025 Kalmaegi. Das ist gezählt, keine Statistik, aber es gibt eine Größenordnung. Dazu kam das Signal für dieses Jahr, ein starkes El Niño. In El-Niño-Jahren treffen statistisch weniger Taifune auf Land, die Studienlage ist allerdings uneinheitlich. Die Kurzfassung des Spezialisten: „Das senkt das Risiko, nimmt es nicht auf null.“
Vorhersagen helfen erst spät. Einen groben Hinweis gibt es sieben bis zehn Tage vorher, eine belastbare Zugbahn drei bis fünf Tage vorher, offizielle Warnstufen oft erst ein bis anderthalb Tage, bevor der Wind kommt. Deshalb ist mein Plan um diese Fenster herum gebaut:
- Geflogen bin ich im späteren der möglichen Reisefenster, nach den Wochen mit den meisten Treffern.
- Das Hauptziel kam zuerst, mit einem Puffertag. Bis zum Abflug ließ sich die Reihenfolge der Ziele noch tauschen, ohne die Flüge anzufassen.
- Am Tag vor dem Abflug kam der letzte Check: kein Tief, kein Taifun im Gebiet.
- Für jeden Tag steht ein Plan B im Plan. Fallen die Boote aus oder zeigen sich keine Haie, rücken die Haitauchgänge einen Tag nach hinten.
Auch Reiseversicherungen hat das System geprüft. In keinem der geprüften Tarife ist ein Taifun ein Grund für einen Rücktritt, nur für einen Abbruch der Reise. So etwas erfährt man sonst gern erst im Schadensfall.
Einfach erklärt
Eine KI kann Dinge erfinden, die plausibel klingen, das sogenannte Halluzinieren. Deshalb muss bei mir jede Aussage einen Beleg mitbringen: einen Link mit Abrufdatum und, wo es geht, eine offizielle Stelle wie den philippinischen Wetterdienst. So kann ich jede Zahl selbst nachprüfen, und das System sieht, wie alt eine Information ist.
Tiefer abtauchen
Die Datenquellen trennt das System nach Zeithorizont. Für die Saison: die El-Niño-Einschätzung des US-Klimazentrums NOAA und die Saisonprognose des philippinischen Wetterdienstes PAGASA. Für die Wochen davor: dessen Zwei-Wochen-Ausblick auf mögliche Stürme, ausdrücklich mit hoher Unsicherheit. Für die letzten Tage: Formationswarnungen des Joint Typhoon Warning Center und die offiziellen Signalstufen. Für das Tageswetter im Plan ruft ein Skript Open-Meteo ab. Mehr als gut zwei Wochen voraus gibt es dort keine Vorhersage, dann rechnet das Skript ein Mittel aus den letzten fünf Jahren und schreibt ausdrücklich „Klima, kein Forecast“ dazu.
Jeder Eintrag im Wissensordner hat außerdem ein Verfallsdatum. Preise gelten 30 Tage, Fahrpläne 90 Tage, danach steht „prüfen“ dran. Gelöscht wird nichts, aber nichts Altes geht ungeprüft in einen neuen Plan.
Keine Warnung für Cebu, trotzdem neue Regeln
Bevor eine Station in den Plan kommt, macht ein Spezialist eine Lageeinschätzung. Er liest die Reise- und Sicherheitshinweise des Auswärtigen Amts und gleicht sie mit denen von acht weiteren Regierungen ab, von Großbritannien bis Neuseeland.
Jede Aussage kommt mit Wortlaut, Stand der Quelle und Abrufdatum, und er liefert „Quelle X sagt Y“, nicht seine eigene Auslegung. Widersprechen sich zwei Regierungen, stehen beide Wortlaute nebeneinander, und die Lücke wird benannt. Selbst eine US-Seite, die oben ein anderes Datum trug als im Fußbereich, hat er so ausgewiesen. Im Ergebnis stand dann: „Welches Datum wofür gilt, ist offen.“ Entscheiden tue ich.
Für Cebu war das Bild klar: Keine der neun Regierungen nennt die Insel als Warngebiet. Trotzdem hat die Einschätzung den Plan verändert. Das Auswärtige Amt rät landesweit von Nachtfahrten ab, also fährt im Plan nach 18:30 Uhr kein Transfer mehr. Und es rät, Fähren zu meiden, wo es Alternativen gibt, also sind die Transfers privat organisiert.
Dazu kommen Funde, nach denen ich selbst kaum gesucht hätte. Der Honorarkonsul in Cebu war fast die ganze Reisezeit abwesend. Und die Druckkammer in Cebu City ist nur mit einer Quelle von 2019 belegt. Ob sie heute in Betrieb ist, ist unbestätigt, also lautet der Vermerk: telefonisch bestätigen.
Kein Ersatz für gesunden Menschenverstand
Das Agentensystem sammelt viel und kann sich trotzdem irren, auch mit Quellenangabe. Was hilft, ist das, was man selbst gelernt hat, und ein gutes Gespür dafür, ob man gerade eine Halluzination liest. Beim Tauchen heißt das: Maßgeblich bleiben Tauchcomputer, Tauchbasis, Guide und die offiziellen Empfehlungen, etwa von DAN.
Einfach erklärt
Reisehinweise ändern sich. Jede Aussage trägt deshalb zwei Daten: wann die Behörde sie geschrieben hat und wann mein System sie gelesen hat. Ist eine Information zu alt, wird sie neu geprüft, die Sicherheitslage zum Beispiel noch einmal ab etwa vier Tagen vor dem Abflug.
Vorher getippt, hinterher verglichen
Vor der Abreise hat der Evaluator für jeden Tag vorhergesagt, wie er mir gefallen wird, auf einer dreistufigen Skala von sehr gut über okay bis schlecht. Für den ersten Haitag stand dort „sehr gut“, und genau so habe ich ihn nach dem Tauchgang auch bewertet.
Spannender sind die Stellen, an denen das System unsicher war. Für zwei Makro-Tauchtage an einem anderen Ort stand nur „okay“, beim zweiten mit niedriger Konfidenz, also mit wenig Sicherheit, und dem Vermerk „Profil-Lücke“. Gemeint war: Mein Profil sagt nichts darüber, ob mir Tauchen gefällt, wenn ich nicht gut fotografieren kann. Ich habe nur ein Weitwinkelobjektiv dabei, für Makro bringt das fotografisch wenig. Ist so ein Tauchgang dann ein Erlebnis oder Füllprogramm? Statt zu raten, hat das System mir die Frage gestellt.
Die Makro-Tage sind später aus der Route geflogen. Die Antwort kam trotzdem, auf Malapascua. Nach den ersten Tauchgängen habe ich festgehalten, dass ich mit meinem Objektiv kein Makro fotografieren kann. Ins Profil kommt das frühestens mit der Retro, der Auswertung nach der Reise. Die Antwort auf die Frage des Evaluators steht aber schon in meinem Reisebericht: Auf den Makrospots übe ich eher, als gute Bilder zu machen, und auch das gefällt mir.
Tiefer abtauchen
Der Evaluator arbeitet mit einer festen Rangfolge. Wünsche für die konkrete Reise gehen vor allgemeinen Geschmacksregeln, die gehen vor Standardannahmen. Innerhalb der Regeln zählt „hart“ vor „stark“ vor „schwach“. Vermutungen aus früheren Reisen dienen nur dazu, einen Gleichstand aufzulösen, und sind als Hypothese markiert.
Wo das Profil zu einer wichtigen Frage schweigt, schreibt er „Profil-Lücke“ und formuliert eine konkrete Frage. Für diese Reise waren es sieben, etwa zu frühen Tauchgängen oder zu Abenden allein. Die Antworten landen zuerst im Feedback-Log, Profildateien ändert der Evaluator nie selbst. Kalibriert ist er bisher nur an der Norwegen-Reise, die Philippinen sind die erste Solo-Reise im System.
Cockpit, Karte, Logbuch, Booklet
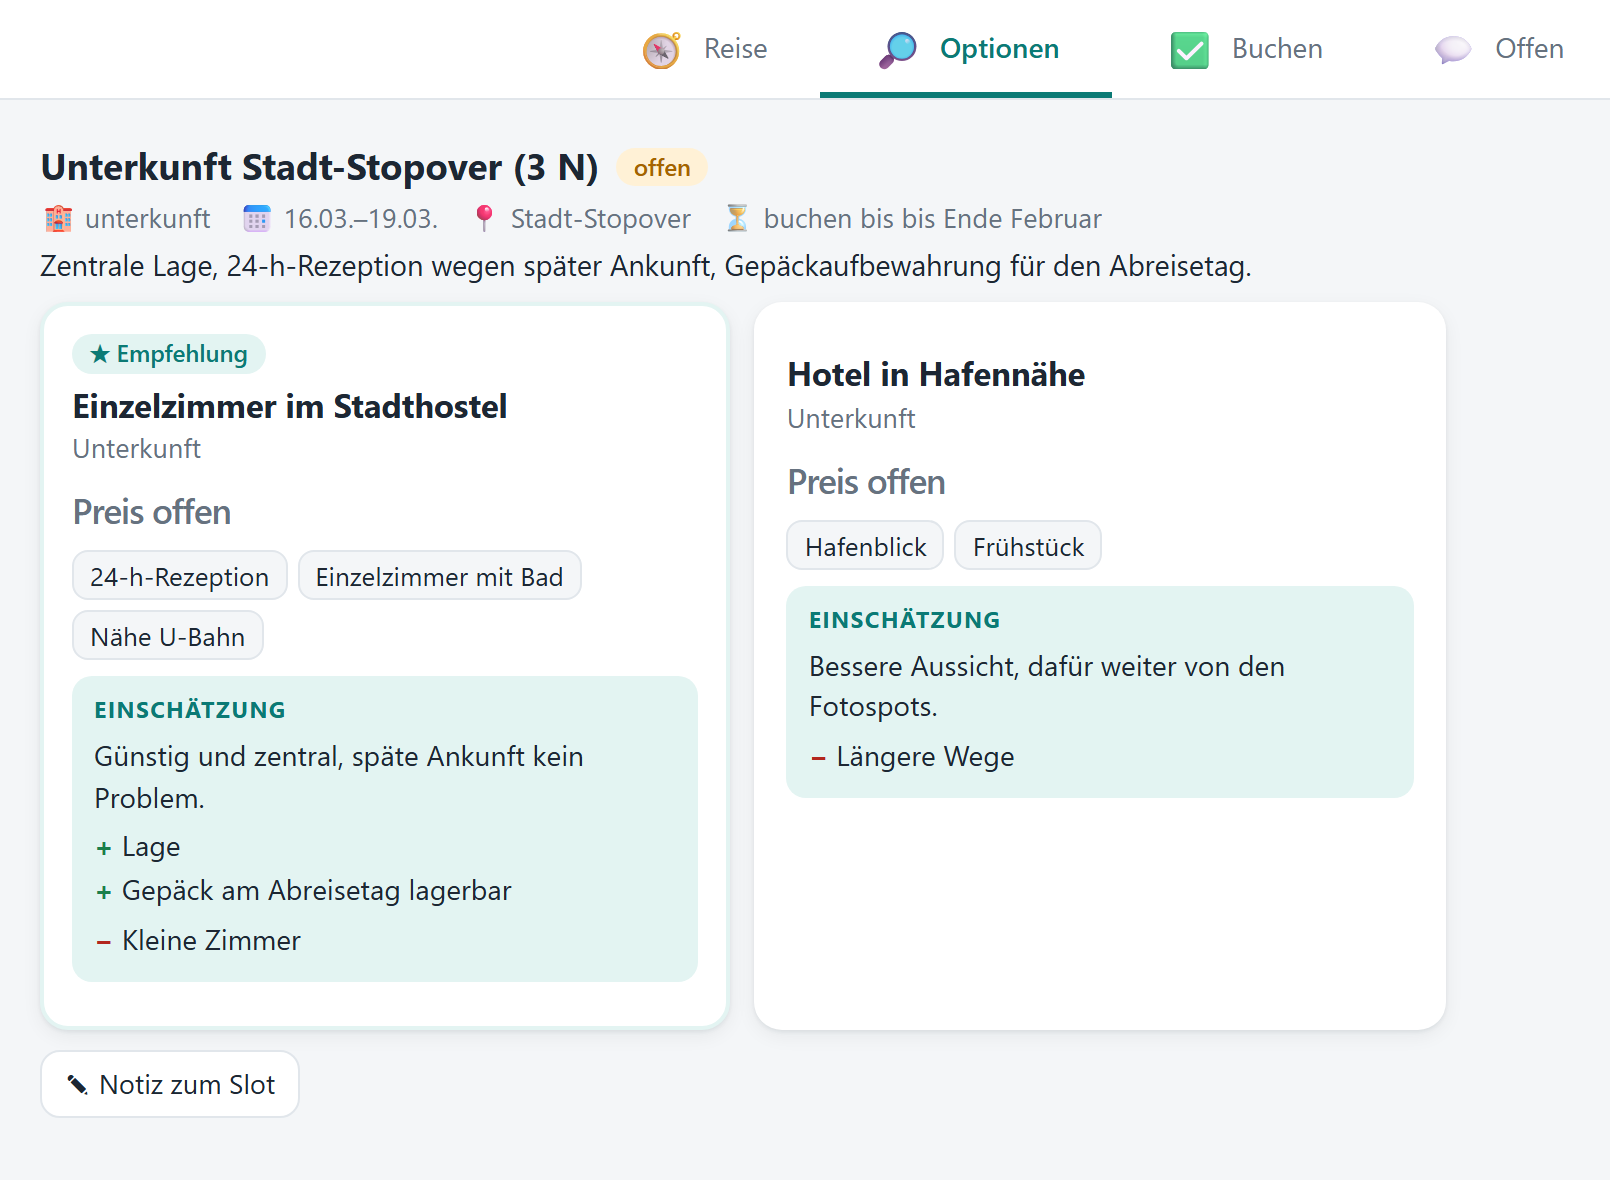
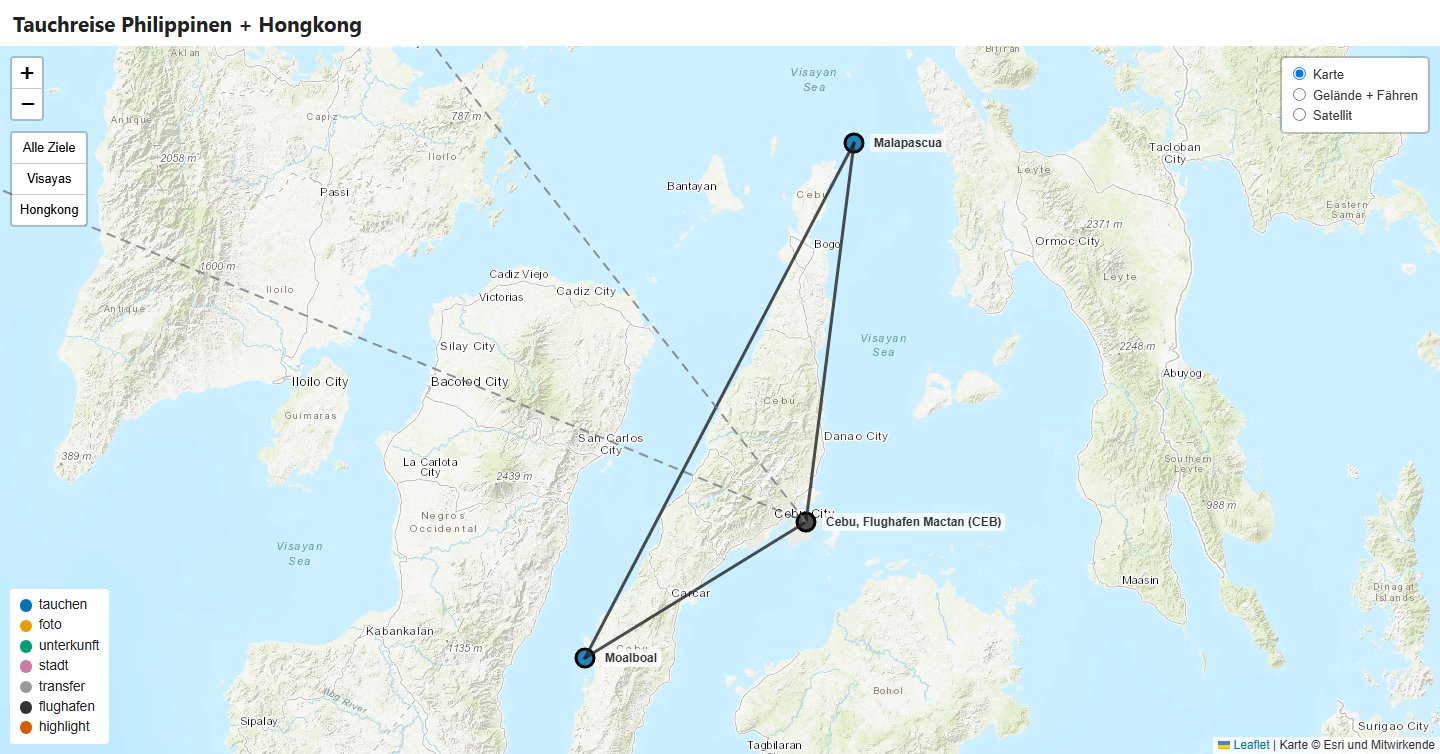
Aus der Planung entstehen vier Dinge, die ich wirklich benutze. Cockpit und Logbuch zeigen Beispieldaten mit erfundenen Orten, die Karte meine echte Route ohne Daten.
Das Cockpit legt pro Entscheidung zwei oder drei Optionen nebeneinander, jede mit Einschätzung, Plus und Minus. Ich klicke Daumen, „Nehme ich“ oder schreibe eine Notiz, ein Knopf schickt alles gesammelt zurück in den Chat. So habe ich Unterkünfte und Transfers dieser Reise entschieden.
Die Karte zeigt alle Stationen, Transfers und Varianten mit Zeitleiste, dazu gibt es eine Datei für Google Earth.
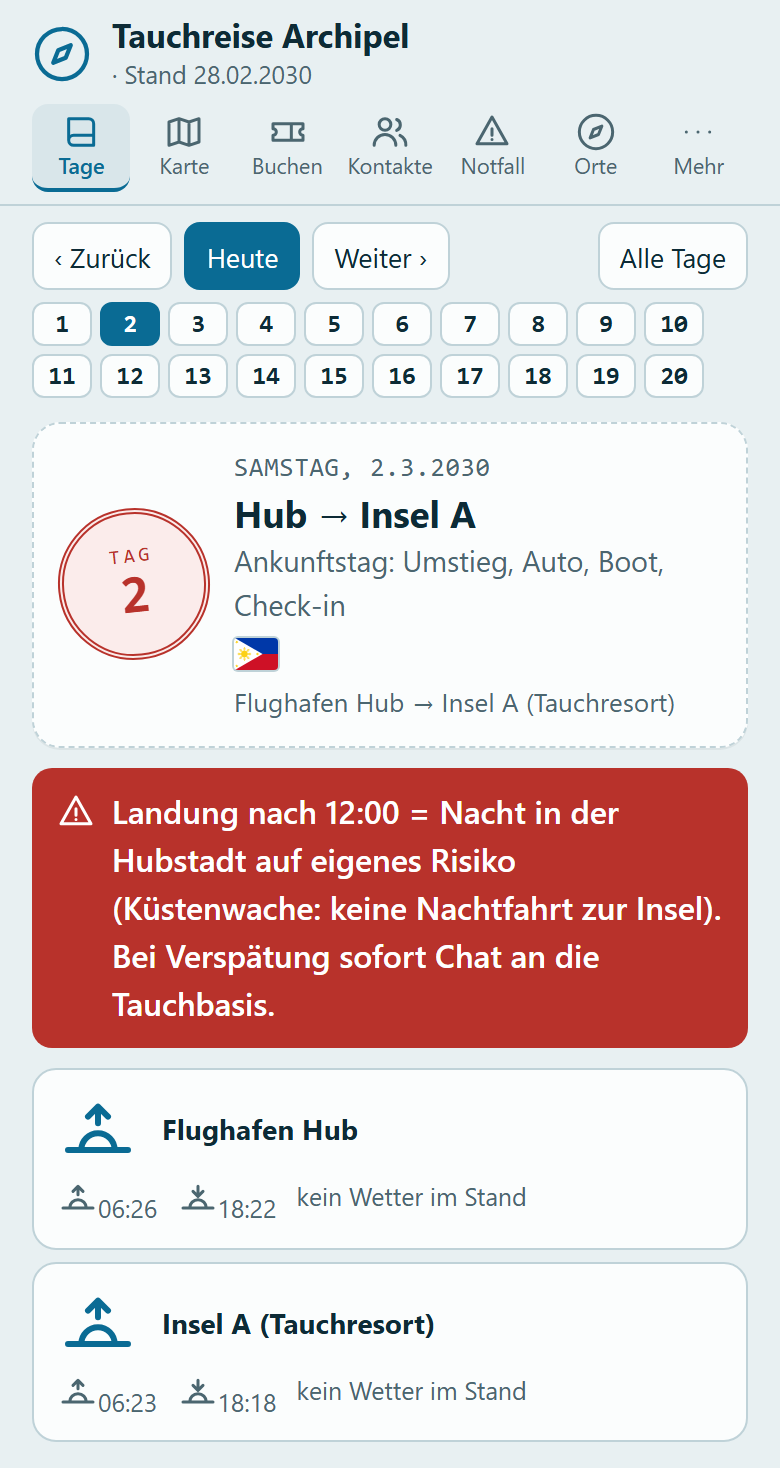
Das Logbuch läuft offline auf dem Handy, Tag für Tag: was ansteht, wann die Sonne aufgeht, wen ich anrufe, was im Notfall zu tun ist. Jeder Eintrag lässt sich aufklappen und zeigt, woher die Information stammt.
Das Booklet ist ein Heft als PDF für Familie und Freunde, eine Station pro Seite, ohne Kosten und Kontaktdaten. Entstanden ist es, weil mir die erste, nüchterne Fassung zu wenig von dem zeigte, was ich geplant hatte.
Gebaut hat die Oberflächen Claude, nach 80/20. Manches davon würde optisch als „AI slop“ durchgehen, mir waren Inhalt und Quellen wichtiger.
Agenten, Chat oder Reisebüro
Natürlich könnte ich Claude einfach fragen, wo man im November gut taucht. Die Antwort käme aus dem Trainingswissen des Modells, also aus Texten bis zu einem Stichtag: allgemein, ohne Datum, ohne Quelle, und im nächsten Chat wieder vergessen. Mein System lädt dagegen Profil, Wissen und Plan als Dateien nach und recherchiert aktuell im Web.
| Chat-KI | Reisebüro | Agenten-Team | |
|---|---|---|---|
| Kennt meinen Geschmack | nein jedes Mal neu erklären | teilweise je nach Berater | ja Regeln mit Belegen |
| Aktuelle Infos mit Quelle | teilweise je nach Websuche | teilweise Katalog und Erfahrung | ja Quelle und Datum pro Aussage |
| Rechnet Anschlüsse und Fristen durch | teilweise ohne Gegenprobe | teilweise bei Pauschalreisen | ja ganze Kette mit Plan B |
| Plant Tauch- und Foto-Details mit | teilweise | teilweise beim Spezialveranstalter | ja Nitrox, Kameraraum, Licht |
| Erreichbar unterwegs, auch nachts | ja | teilweise Notfallnummer | ja über das Handy |
| Lernt aus Feedback und Kontext | nein | teilweise der gute Berater | ja Vorhersage gegen Urteil |
| Bucht und kümmert sich bei Problemen | nein | ja | nein buchen tue ich selbst |
Ein gutes Reisebüro bucht für mich und hilft, wenn etwas schiefgeht. Das kann mein System nicht, und das will ich auch nicht abgeben. Dafür kennt es meine Vorlieben bis zum Kameraraum der Tauchbasis, sucht in Landessprachen nach Tipps von Einheimischen, nennt zu jeder Empfehlung ein Gegenargument und ist nachts um zwei auf dem Handy erreichbar. Es ersetzt das Reisebüro also bis kurz vor der Kasse.
Umplanen vom Handy
Für unterwegs gibt es einen eigenen Befehl, /adapt. Die Anleitung dazu geht davon aus, dass ich vom Handy schreibe, oft kurz, oft früh oder müde. Die Antwort ist deshalb kurz: was los ist, zwei konkrete Optionen mit ihren Folgen, eine Empfehlung. Erst wenn ich gewählt habe, ändert Claude Plan, Logbuch und Karte. Auf dieser Reise habe ich so meine Tauchgänge umgestellt.
Daneben ist das System unterwegs mein Notizbuch mit Gedächtnis. Ich fotografiere den Aushang mit Preisen und Gebühren an der Tauchbasis, schicke das Foto in die Sitzung, und daraus wird ein Wissenseintrag mit meinem Foto als Quelle. Dass an einem Tauchplatz ein Tunnel gesperrt ist, landet genauso im Wissen.
Für medizinische Notfälle oder eine Sicherheitslage hat /adapt einen eigenen Modus: keine Optionen, keine Recherche, nur Notrufnummer, Klinik und Druckkammer aus der vorher belegten Recherche, mit Stand-Datum, und die Bitte, mich zu melden, wenn ich in Sicherheit bin. Steht dort nichts Belegtes, sagt das System „nicht belegt“, statt eine Nummer aus dem Gedächtnis zu nennen.
Einfach erklärt
In Claude Code lassen sich wiederkehrende Abläufe als Befehl ablegen, eine Art gespeichertes Rezept in einer Textdatei. Tippe ich /adapt, liest Claude dieses Rezept und hält sich daran: kurz antworten, zwei Optionen, eine Empfehlung, erst nach meiner Wahl etwas ändern. So muss ich das nicht jedes Mal neu erklären, schon gar nicht morgens um fünf vom Handy.
Tiefer abtauchen
/adapt liest bewusst wenig: vom Plan nur heute und die zwei folgenden Tage, das Ende des Reiselogs, den Abschnitt mit Buchungen und Stornofristen und nur die Geschmacksregeln, die die Störung berührt. Danach höchstens drei kurze Recherchen, etwa Wetter, Fähren und Flugstatus. Einen Spezialisten startet es nur bei echtem Bedarf.
Die Antwort hat ein festes Format von höchstens etwa zwölf Zeilen:
- ein Satz zur Lage, mit Zeit und Quelle
- Option A und Option B, jeweils mit Folgen für die nächsten Tage, Buchungen und Stornofristen und dem, was ich dafür aufgebe
- eine Empfehlung mit Begründung in einem Satz
- höchstens ein offener Punkt
Geschrieben wird erst nach meiner Wahl: Plan, Logbuch und Karte neu, dazu ein Commit-Vorschlag.
Unter der Haube
Ab hier wird es technisch. Angefangen hat alles mit einem langen Chat mit Claude. Irgendwann waren frühe Entscheidungen wieder aus dem Blick, und ein Chat, der immer länger wird, ist keine Dauerlösung. Fast alles, was jetzt kommt, ist eine Antwort auf dieses Problem. Weil Claude Code ohnehin meine gewohnte Entwicklungsumgebung ist, bin ich dorthin umgezogen.
Das System ist seitdem ein Git-Repository, also ein Projektordner mit Versionsgeschichte, voller Konfiguration für Claude Code: Agenten-Definitionen, Skills (gespeicherte Abläufe wie /adapt), Regeln, zwei Hooks (kleine Programme, die an festen Stellen automatisch anspringen), ein paar Python-Skripte und viel Markdown. Kein eigener Server-Code, keine Datenbank.
Fünf Phasen, fünf Befehle
Jede Reise läuft durch dieselben Phasen:
/pitchordnet eine Idee ein, mit Gegenargument und Reisezeit-Ampel für alle zwölf Monate./rahmenlegt Route, Flüge und Unterkünfte in drei Recherche-Wellen fest. Danach gebe ich den Rahmen frei, vorher geht es nicht weiter./detailplant Tag für Tag und erzeugt Cockpit und Logbuch./adaptist für unterwegs./retroholt nach der Reise mein Urteil ab und vergleicht es mit den Vorhersagen.
Ein Orchestrator, sieben Rechercheure
Der Orchestrator läuft auf Opus, dem stärksten Modell, und erledigt Kleinigkeiten selbst. Alles, was viel Lesen erfordert, geht an die Worker, die Rechercheure. Die Modellwahl folgt einer Leiter: Haiku, das kleinste Modell, macht die breite, rohe Suche in Landessprachen. Sonnet recherchiert gezielt und prüft nach. Opus urteilt über meinen Geschmack, und zwar nur über kurze Listen.
Eine Regel hat sich früh bewährt: Worker bewerten nie nach Geschmack. Der Tauch-Spezialist filtert nach harten Kriterien, etwa ob ein Spot tiefer als 30 Meter liegt. Ob mir eine Basis gefällt, entscheidet er nicht.
Einfach erklärt
Anthropic bietet seine KI in drei Größen an. Haiku ist klein, schnell und günstig, Sonnet ist der Allrounder, Opus ist das stärkste und teuerste Modell. Das ist wie in einem Team: Für eine breite Suche in zwanzig Quellen braucht es keinen Abteilungsleiter. Für die Frage, was wirklich zu mir passt, schon.
Tiefer abtauchen
Jeder Worker ist in Claude Code ein Subagent: eine Markdown-Datei mit einem Kopf, der Name, Beschreibung, erlaubte Werkzeuge, Modell, Denkaufwand und vorgeladene Skills festlegt. Der Tauch-Spezialist darf zum Beispiel suchen, Webseiten lesen und Dateien schreiben, läuft auf Sonnet mit mittlerem Aufwand und lädt das gemeinsame Protokoll für Aufträge vor.
Jeder Subagent arbeitet in seinem eigenen Kontext. Er sieht nichts vom Gespräch zwischen mir und dem Orchestrator, und zurück kommt nur sein Ergebnis. Über die Werkzeugliste lässt sich steuern, was ein Agent überhaupt kann. Der Evaluator etwa hat gar keine Web-Werkzeuge. Höchstens drei Worker laufen gleichzeitig.
Agenten teilen kein Gedächtnis
So bleiben 50 Seiten Recherche in einer Datei, nicht im Gespräch.
Jeder Worker startet ohne Vorwissen und weiß nur, was in seinem Auftrag steht. Der Orchestrator schickt einen Auftrag mit immer denselben vier Teilen: Ziel, Kontextpfade, Ausgabedatei und Fertig-Kriterien. Was nie drinsteht: welche Option der Orchestrator bevorzugt.
Der Worker schreibt eine Ergebnisdatei und meldet in höchstens 15 Zeilen zurück. Der Orchestrator liest zuerst nur diese Rückmeldung und die Kurzfassung der Datei. So bleiben 50 Seiten Recherche in einer Datei und nicht im Gespräch mit mir. Alle Worker teilen dieselben Spielregeln: erst das vorhandene Wissen, dann das Web, offizielle Quellen vor Reiseführern vor Erfahrungsberichten. Und wenn eine Seite blockt, wird nichts umgangen, kein Login, keine Proxies.
Tiefer abtauchen
Die Fertig-Kriterien sind eine überprüfbare Checkliste. Beim Tauch-Spezialisten steht zum Beispiel drin, dass für jede Basis Nitrox, Kameraraum, Gruppengröße, Guides und Sauerstoff entweder belegt oder ausdrücklich als „nicht belegt“ markiert sein müssen, dass die Flugpause nach dem letzten Tauchgang aus einer offiziellen Quelle stammt und dass die nächste Druckkammer genannt ist.
Die Ergebnisdatei beginnt mit einer Kurzfassung von höchstens zehn Zeilen: Antwort, Empfehlung, größte Unsicherheit. Danach folgen eine Befund-Tabelle, Details, Quellen mit Abrufdatum und Typ (offiziell, Reiseführer, Erfahrungsbericht) und offene Punkte. Fakten, die über die Reise hinaus nützen, legt der Worker zusätzlich in eine Inbox. Die Rückmeldung an der Orchestrator nennt den Status (fertig, teilweise, blockiert), höchstens fünf Kernbefunde, die Dateien und offene Fragen.
Der Evaluator erfährt nie, was der Orchestrator will
Den Evaluator habe ich in seiner Definition als meinen Anwalt beschrieben. Er liest mein Profil, meine Geschmacksregeln und die Kandidaten und urteilt. Recherchieren kann er nicht, dafür hat er nicht einmal die Werkzeuge. Er kennt weder die Vorliebe des Orchestrators noch die Ergebnisse früherer Läufe, jede Shortlist bekommt einen eigenen, frischen Lauf. Und er darf zu allen Kandidaten Nein sagen. Gemessen habe ich nicht, ob das wirklich gegen Gefälligkeit hilft, es ist eine Vorsichtsmaßnahme.
Dazu kommt das Prüfgremium aus mehreren Sitzen mit je einer Rubrik, etwa Logistik, Sicherheit, Fotograf, Taucher. Jeder Sitz sieht nur seine Rubrik und den Plan und gibt höchstens 25 Zeilen zurück. Der Orchestrator sortiert die Befunde nach Stelle im Plan und benennt Konflikte zwischen den Sitzen offen. Ich entscheide pro Punkt: übernehmen, verwerfen oder später.
Einfach erklärt
Sprachmodelle neigen dazu, einem nach dem Mund zu reden. Steht im Auftrag „Ich finde Option A gut“, findet das Modell oft auch Option A gut. Im Englischen heißt das Sycophancy, auf Deutsch etwa Gefälligkeit. Mein Evaluator bekommt deshalb nie zu sehen, was der Orchestrator bevorzugt. Wie ein Gutachter, der nicht weiß, welches Angebot der Chef gut findet.
Auf dem Schreibtisch liegt nur, was gebraucht wird
Das Teuerste in so einem System ist der Kontext, also alles, was das Modell für eine Antwort gerade vor sich hat: das bisherige Gespräch, jede geöffnete Datei, jede Anleitung. Am besten stellt man sich ihn als Schreibtisch vor. Je mehr darauf liegt, desto unübersichtlicher wird es. Antworten werden langsamer und teurer, Details gehen unter, und irgendwann ist der Tisch voll. Das Repository ist der Aktenschrank daneben: Profil, Wissen, Pläne und Regeln liegen dort in Ordnern, und für jede Aufgabe kommt nur die Akte auf den Tisch, die gerade gebraucht wird.
Lange Sitzungen enden mit /handoff – die nächste startet frisch.
Fast jede Designentscheidung im Repo zielt darauf, den Tisch leer zu halten:
- Beim Start lädt ein Hook nur die Übergabe-Notiz (höchstens 60 Zeilen), die nächsten Roadmap-Punkte und die Zahl ungelesener Funde.
- Formatregeln für Reisen, Profil und Wissen laden nur, wenn eine passende Datei berührt wird.
- Das Wissen hat einen Index mit einer Zeile pro Datei. Agenten lesen zuerst den Index, dann nur den nötigen Abschnitt.
- Erweiterungen wie die Flugsuche hängen nur am Worker, der sie benutzt.
Eine frische Sitzung startet so bei rund 35.700 Tokens, den Wortstücken, in denen ein Modell liest und abgerechnet wird. Das ist eine Menge und sicher noch optimierbar. Ein guter Teil davon ist aber Anpassung an mich, und die soll drin sein.
Tiefer abtauchen
Der Start-Hook ist in Claude Code ein SessionStart-Hook, der beim Start, beim Fortsetzen, nach dem Leeren und nach dem Komprimieren einer Sitzung läuft und seinen Text in den Kontext einspielt. Die Formatregeln sind Regel-Dateien mit einer paths:-Angabe im Kopf, etwa trips/**. Claude Code lädt sie erst, wenn eine Datei unter diesem Pfad berührt wird.
Lange Sitzungen enden mit /handoff: eine Übergabe-Notiz von höchstens 40 Zeilen, und die nächste Sitzung startet frisch, statt einen vollen Schreibtisch mitzuschleppen.
Ohne Quelle kein Wissen, ohne Bestätigung keine Regel
Wissen: ohne Quelle kein Eintrag. Rohfunde der Worker landen in einer Inbox, ins eigentliche Wissen übernimmt sie nur der Orchestrator. Dass jede Aussage eine Quelle hat, prüft ein Hook vor jedem Schreibvorgang. Auf die Disziplin des Modells verlasse ich mich dabei nicht. Meine eigene Erfahrung zählt als Quelle, bleibt aber „unverifiziert“, bis eine offizielle oder zweite Quelle sie bestätigt. Eine bewusste Schwäche hat der Hook: Stürzt er selbst ab, lässt er die Änderung durch, damit ein Fehler im Hook nicht die ganze Sitzung lahmlegt.
Geschmack: ein Datenpunkt ist keine Regel. Mein Profil enthält Geschmacksregeln mit Belegen. Rohsignale gehen ins Feedback-Log, mit Urteil und meinem Wortlaut, etwa mein Urteil über eine Fähre ohne Reservierung auf einer Norwegen-Reise: zu viel Unsicherheit. Was ich ausdrücklich sage, gilt sofort als Regel. Was das System nur ableitet, bleibt Hypothese, bis es zwei unabhängige Bestätigungen gibt und ich zustimme. Auf Malapascua ist zum Beispiel die Vermutung dazugekommen, dass mir flache Tauchplätze besser gefallen.
Dazu kommt der Vergleich zwischen Vorhersage und Urteil. Nach der Reise trägt /retro meine Urteile neben die Vorhersagen des Evaluators und rechnet Trefferquote und Abweichung aus. Die Retro der Norwegen-Reise brachte 24 Urteile (14 sehr gut, 8 okay, 2 schlecht), eine neue Regel und zwei neue Hypothesen.
Einfach erklärt
Ein Hook ist ein kleines Programm, das automatisch an einer festen Stelle anspringt, zum Beispiel jedes Mal, bevor die KI eine Datei speichert. Er funktioniert wie ein Türsteher: Die KI kann ihn weder überreden noch vergessen. Eine Anweisung im Text kann ein Modell übersehen, an einem Hook kommt es nicht vorbei.
Tiefer abtauchen
Der Quellen-Hook ist ein PreToolUse-Hook auf die Werkzeuge zum Schreiben und Bearbeiten. Claude Code ruft vor jedem Schreibvorgang ein Python-Skript auf und übergibt, was geschrieben werden soll. Das Skript prüft nur Einträge im Wissensordner, und nur die, die neu sind oder sich geändert haben. Als Quelle gilt eine URL, ein Pfad im Repo oder ein Belegwort wie „Beobachtung“ oder „Messung“. Fehlt sie, endet das Skript mit Exit-Code 2, und die Fehlermeldung samt Regel geht zurück an das Modell. Das muss die Quelle nachliefern oder den Eintrag lassen.
Der Hook prüft nur, ob eine Quelle dasteht, nicht, wie gut sie ist. Ein Beispiel aus meinem Wissensordner: Die Fuchshaie sollen von einem tieferen auf einen flacheren Platz gewandert sein. Belegt ist das bisher nur durch einen einzelnen Artikel. Der Eintrag kommt durch, steht aber als „unverifiziert“ und „flüchtig“ drin. „Verifiziert“ heißt bei mir: Primärquelle oder zwei unabhängige Quellen. Diese zweite Stufe ist eine Regel in den Anweisungen, kein Hook.
Die KI pflegt Daten, Skripte zeichnen
Gleiche Daten, gleiches Ergebnis – das Modell zeichnet nie selbst HTML.
Karte, Cockpit, Logbuch und Booklet erzeugen Python-Skripte ohne externe Abhängigkeiten. Das Modell pflegt nur einfache Datendateien mit Stationen, Strecken und Routenvarianten. HTML jedes Mal vom Modell erzeugen zu lassen wäre teuer und fehleranfällig. So kostet ein Update ein paar Zeilen Daten und einen Skriptlauf, und falsche Koordinaten fallen auf der Karte sofort auf. Ein weiteres Skript rechnet für jede Station Sonnenzeiten, goldene und blaue Stunde, Mondphase und Wetter, daraus plant der Foto-Spezialist die Lichtfenster.
Der Booklet-Renderer prüft außerdem alle Texte auf Geldbeträge, Zahlstatus, Telefonnummern, Mailadressen und Anschriften und bricht mit einer Trefferliste ab. Das Heft geht an Familie und Freunde, und ich verlasse mich lieber auf einen regulären Ausdruck als auf die Aufmerksamkeit eines Modells.
Einfach erklärt
Die KI füllt nur ein Formular aus: Wo bin ich wann, wie komme ich von A nach B, was ist schon gebucht. Karte, Cockpit und Heft zeichnet jedes Mal dasselbe feste Programm. Das ist günstiger, als die KI jedes Mal eine ganze Webseite schreiben zu lassen, und es sieht jedes Mal gleich sauber aus.
Ein Server zu Hause, das Handy als Fernbedienung
Unterwegs habe ich keinen Laptop dabei. Das System läuft auf einer eigenen virtuellen Maschine (VM) auf meinem Heimserver. Auf dem Handy öffne ich die Claude-App, Tab „Code“, und bin in derselben Umgebung wie am Schreibtisch.
Eine KI mit Shell-Zugriff soll nicht durchs Heimnetz spazieren. Die VM ist deshalb abgeschottet:
- Remote Control baut nur ausgehende HTTPS-Verbindungen auf, es gibt keine offenen Ports.
- Eine Firewall lässt die VM ins Internet, aber nicht zu den anderen Geräten im Haus.
- Claude läuft als eigener Benutzer ohne Administratorrechte. Zugang zu GitHub hat die VM nur über einen Schlüssel, der für genau dieses eine Repository gilt.
Laptop und VM synchronisieren sich über Git: zu Beginn git pull, am Ende pushen, nie gleichzeitig. Gelernt habe ich das auf die harte Tour, als die VM auf einem alten Stand dieselbe Inbox ein zweites Mal ausgewertet hat. Als Rückfall gibt es eine Cloud-Sitzung auf claude.ai, allerdings ohne die privaten Dateien.
Einfach erklärt
Mein Server zu Hause ruft selbst bei Anthropic an und hält die Leitung offen. Von außen kann niemand anrufen, es gibt keine offene Tür ins Heimnetz. Das Handy schickt meine Nachricht an Anthropic, der Server holt sie dort ab und antwortet auf demselben Weg. Für mich fühlt es sich an, als säße ich am Schreibtisch.
Tiefer abtauchen
Auf der VM startet ein systemd-Dienst claude remote-control in einer tmux-Sitzung und startet es neu, wenn es abstürzt. Der GitHub-Zugang ist ein Deploy-Key mit Schreibrecht für dieses eine Repo, Zugangsdaten zu anderen Systemen gibt es auf der VM nicht.
Vier Fehler, aus denen Regeln wurden
Alle vier stehen inzwischen mit Symptom und Workaround in einem Tool-Logbuch im Repo:
Stille Fehler. Der Flug-Worker hatte plötzlich keine Flugsuche mehr, ohne Fehlermeldung. Claude Code vertraut Projekten pro Pfad, und der Pfad war einmal mit kleinem c:\ und einmal mit großem C:\ eingetragen. Gefunden habe ich es nur im Debug-Log.
Agenten mit altem Gedächtnis. Ein fortgesetzter Worker bekam neue Werkzeuge, behielt aber seine alte Anleitung und deutete um, was er im ersten Lauf getan hatte. Seitdem gilt: Selbstauskünften eines fortgesetzten Workers nicht glauben.
Negativbefunde. Eine Websuche meldete „keine Meldungen“ zu einem Sicherheitsvorfall, den die zuständige Behörde sehr wohl gemeldet hatte. Seitdem zählt ein „nichts gefunden“ nicht als Beleg.
Das Nutzungslimit. Viele parallele Worker reißen das Kontingent. Ihr Stand bleibt aber erhalten, und nach dem Reset geht es weiter.
Selber bauen
Man braucht dafür keine sieben Spezialisten. Ein sinnvoller Einstieg, in dieser Reihenfolge:
- Eine kurze
CLAUDE.md: Sitzungsstart, Ordnerstruktur, Rollen, harte Regeln. Unter 100 Zeilen. - Ein Profil: harte Randbedingungen (bei mir Tauchbrevet, Ausrüstung, Urlaubstage) und ein paar Geschmacksregeln mit Beleg.
- Zwei oder drei Worker für die Themen, die am meisten Recherche kosten, mit einem gemeinsamen Protokoll für Auftrag, Ergebnisdatei und Rückmeldung.
- Ein Wissensordner mit Index und Inbox, plus die Regel „ohne Quelle kein Eintrag“. Als Hook, wenn man es ernst meint.
- Daten statt HTML: eine Datei mit Stationen und Strecken und ein kleines Skript, das daraus eine Karte macht.
- Übergabe statt Mammut-Sitzung: eine Übergabe-Notiz, ein Hook, der sie beim Start einspielt, und ein
/handoff-Befehl. - Später: Evaluator mit Vorhersagen und Retro, Prüfgremium, Zugang vom Handy.
Voraussetzung sind Claude Code mit einem Abo, Python ab Version 3.11 und Git. Bei mir läuft alles über ein Claude-Pro-Abo, für eine Reise waren es über 50 Worker-Läufe. Pro reicht, solange man nicht den ganzen Urlaub in einer einzigen Sitzung planen will. Unterwegs ist das Kontingent kein Thema.
Eine entkernte Fassung ohne meine Daten gibt es als Starter-Kit: für mehrere Reisende mit getrennten Geschmacksprofilen, mit Modulen für Tauchen, Foto und Drohne und einem /onboarding, das in etwa 20 Minuten durch die Einrichtung führt. Öffentlich ist es nicht. Wer es ausprobieren will, kann sich gern bei mir melden.
Die erste Kette hat gehalten
Das System läuft, und sein größter Wert ist, wie genau es auf mich zugeschnitten ist: auf meine Urlaubstage, meine Ausrüstung und meine Schmerzgrenze bei 33 Stunden Anreise. Anders machen würde ich vor allem eins: früher auf Grafik und aufbereitete Details setzen statt auf Text im Chat. So kann ich Informationen einfach besser verarbeiten, auch wenn es für Claude mehr Tokens sind.
Ob der Evaluator mich wirklich kennt, zeigt erst die Retro dieser Reise. Noch gespannter bin ich, wie das System nach Reise drei oder vier aussieht. Die erste Kette hat jedenfalls gehalten: Als auf Malapascua die Sonne unterging, lieh ich mir in der Tauchschule schon Tarierweste und Neo.
FAQ
Brauche ich einen Server zu Hause?
Nein. Am Laptop funktioniert alles genauso. Der Server ist nur dafür da, dass ich unterwegs ohne Laptop weiterplanen kann.
Wie viel muss ich programmieren können?
Agenten, Skills und Regeln sind Markdown. Die Python-Skripte hat Claude geschrieben, ich habe die Aufträge formuliert und die Ergebnisse geprüft. Mit Git und einer Kommandozeile sollte man aber umgehen können.
Wo landen meine Daten?
Das Gesprächsprotokoll liegt bei Anthropic, das Repository privat bei GitHub. Die Flugsuche fragt Google Flights ab, die Wetterdaten kommen von Open-Meteo. Buchungscodes und Rechnungen liegen in einem eigenen privaten Ordner.
Funktioniert das auch ohne Tauchen?
Ja. Tauchen und Fotografie sind bei mir eigene Spezialisten und Prüfsitze. Im Starter-Kit sind sie Module, die man abschaltet. Das Grundgerüst aus Orchestrator, Aufträgen, Wissen mit Quellen und Lernschleife ist davon unabhängig.
Mehr zum Thema: wie ich unter Wasser fotografiere, steht im Artikel zur Tauchfotografie. Wie diese Website mit einem ähnlichen Team aus KI-Agenten entsteht, steht im Artikel KI-assistierte Webentwicklung. Weitere Projekte rund um KI stehen im KI-Bereich.